
Kontrola wdrożeń zaczyna się przed pipeline’em
DevOps dla software house’u ma uporządkować drogę zmiany od repozytorium do środowiska klienta: kto ją przygotowuje, co jest sprawdzane, kto akceptuje ryzyko i jak wrócić do poprzedniego stanu. CI/CD jest częścią tego procesu, lecz sam pipeline nie wyjaśni właściciela domeny, dostępu do chmury ani decyzji o publikacji na produkcji.
Ryzyko rośnie, gdy każdy projekt ma inny, nieopisany sposób wdrożenia, a krytyczna wiedza pozostaje przy jednej osobie. Ręczne komendy, współdzielone konta i sekrety wysyłane komunikatorem mogą przyspieszyć pojedynczy release, ale utrudniają odtworzenie jego przebiegu i rozliczenie odpowiedzialności. Celem nie jest maksymalna automatyzacja, tylko powtarzalna zmiana, którą można przejrzeć i zatrzymać.
NIST w SSDF opisuje praktyki bezpiecznego wytwarzania jako działania osadzone w cyklu życia oprogramowania, a nie jako pojedyncze narzędzie przed publikacją. [1] W praktyce software house powinien połączyć kontrolę kodu, konfiguracji, zależności i uprawnień z uzgodnionym sposobem działania po stronie klienta.
Sprawdź zakres DevOps dla software house’u — bez przekazywania sekretów, kluczy ani aktywnych konfiguracji.
Omów kontrolę wdrożeń i środowisk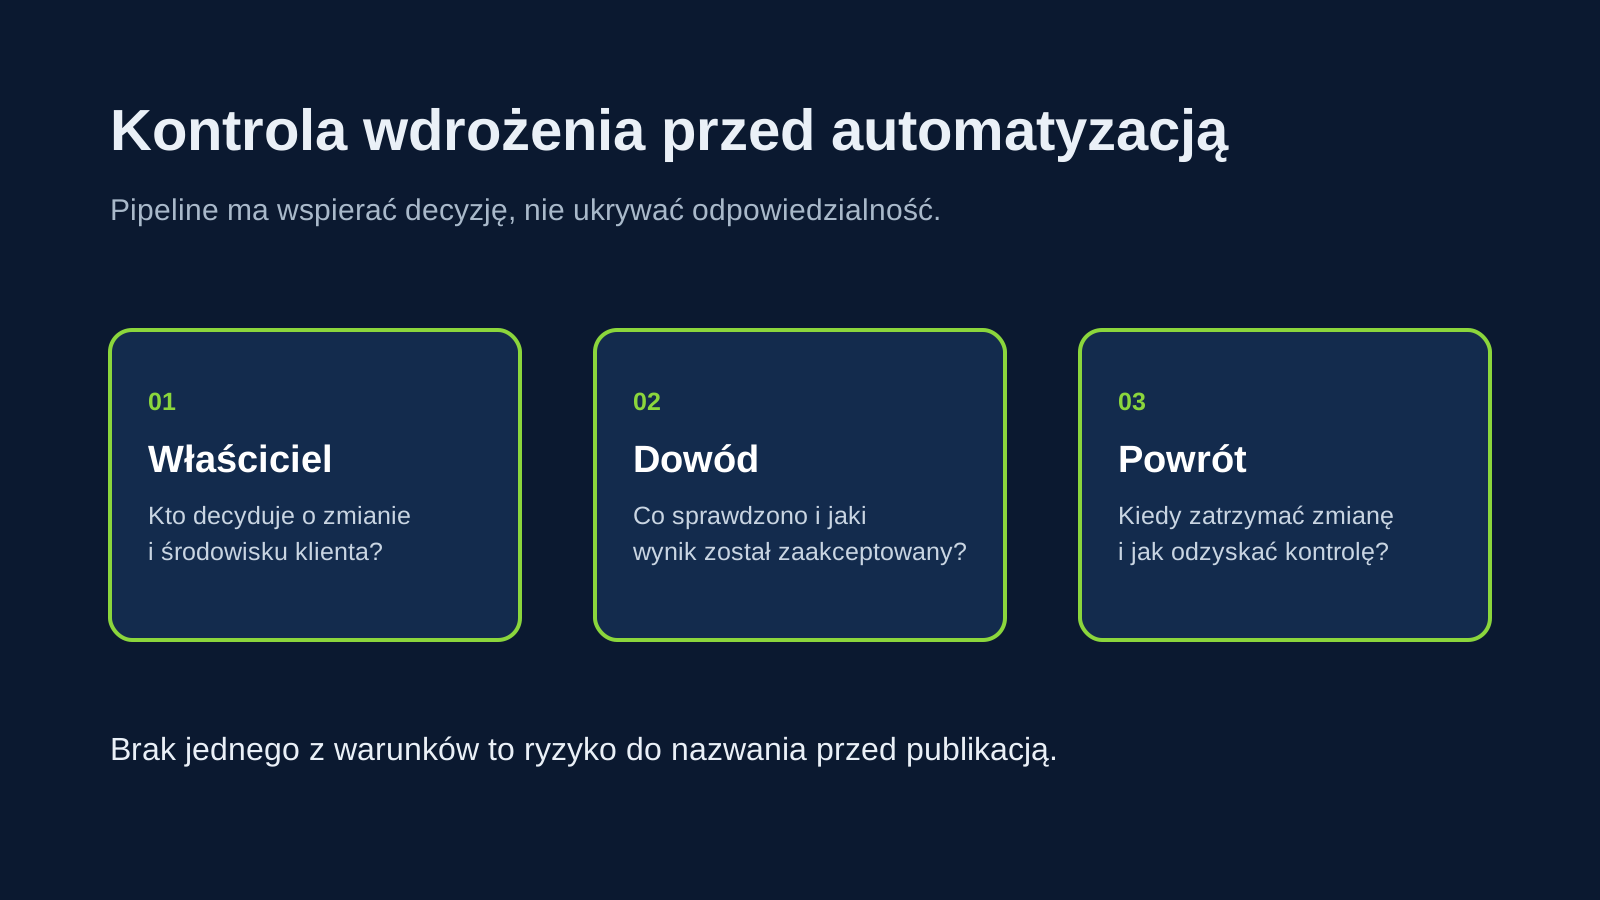
Najpierw ustal granice środowisk i odpowiedzialności
Produkcja, staging i development nie muszą być identyczne kosztowo, ale różnice powinny być znane oraz uzasadnione. Jeśli testy nie odwzorowują kluczowej zależności, nie dają pewności przed wdrożeniem. Warto opisać usługi, dane testowe, integracje zewnętrzne, konta administracyjne i osoby uprawnione do decyzji o zmianie.
W projektach dla wielu klientów trzeba też rozdzielić właściciela aplikacji, tenanta tożsamości, konta chmurowego, domeny, DNS, rejestru obrazów i rozliczeń. Dostęp techniczny nie powinien oznaczać przejęcia własności. Zmiana dostawcy lub osoby w zespole jest mniej ryzykowna, gdy te elementy mają wskazanego właściciela i udokumentowaną drogę odzyskania kontroli.
Współdzielone konta administratora i nieograniczone role utrudniają ustalenie przebiegu zmiany. Lepiej stosować indywidualne tożsamości, role dopasowane do zadania, MFA tam, gdzie jest dostępne, oraz okresowy przegląd uprawnień. Samo wdrożenie tych zasad nie gwarantuje bezpieczeństwa, ale ogranicza zakres dostępu bez właściciela.
Pipeline powinien zostawiać ślad decyzji
Dobrze zaprojektowany pipeline wykonuje powtarzalne kroki: budowanie artefaktu, testy, kontrolę zależności lub konfiguracji oraz publikację do określonego środowiska. Dla każdej bramki warto ustalić wejście, oczekiwany wynik, właściciela wyjątku i sposób zapisania rezultatu. Nie każda niezgodność musi blokować zmianę, ale odstępstwo powinno być świadomą decyzją, a nie ukrytym pominięciem.
Wdrożenie produkcyjne może wymagać innej kontroli niż publikacja na środowisko testowe. Zatwierdzenie nie musi oznaczać wielodniowej procedury: może być prostym potwierdzeniem wyniku testów przez osobę uprawnioną do oceny wpływu. Ważne, aby wiadomo było, jaka wersja została wdrożona, kiedy, przez jaki mechanizm i na podstawie jakiej decyzji.
NIST wskazuje, że praktyki DevSecOps obejmują automatyzację, obserwowalność oraz mechanizmy informacji zwrotnej, lecz ich wdrożenie zależy od architektury i organizacji. [2] Narzędzie nie zastępuje procesu wycofania ani komunikacji z właścicielem usługi.
Opisz ogólnie projekt, środowiska i znane ograniczenia. Nie przesyłaj haseł, tokenów, kluczy ani pełnych konfiguracji.
Przejdź do bezpiecznego formularza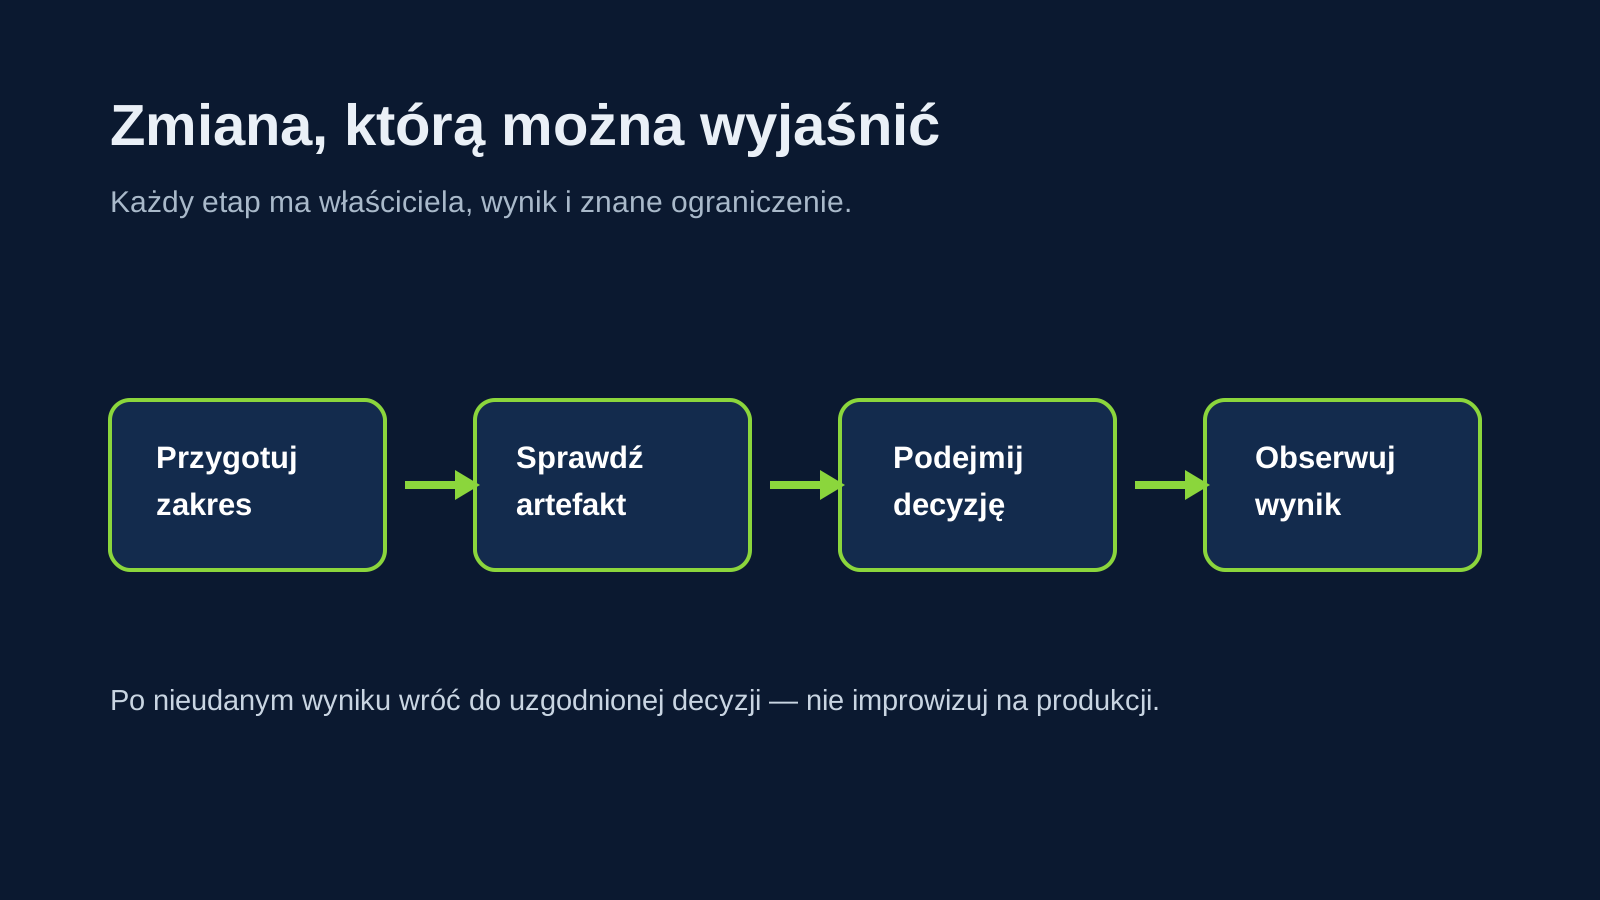
Ograniczenia i ryzyka: sekrety oraz konfiguracja wymagają osobnego procesu
Sekret nie powinien trafiać do repozytorium, historii czatu ani do obrazu aplikacji. Potrzebny jest uzgodniony mechanizm przechowywania, dostęp ograniczony do roli i proces zmiany wartości. Warto wiedzieć, które usługi korzystają z danego sekretu, kto zatwierdza jego rotację oraz jak przetestować zmianę bez przypadkowego zatrzymania integracji.
Infrastruktura jako kod ułatwia powtarzalne tworzenie zasobów i przegląd konfiguracji przed zastosowaniem. Nie usuwa jednak potrzeby ochrony repozytorium, przeglądu zmian, stanu środowiska ani kontroli uprawnień do narzędzia wykonawczego. Różnica między deklaracją w kodzie a stanem produkcji powinna być widoczna i obsługiwana, a nie ignorowana do następnej awarii.
Dane produkcyjne nie powinny być domyślnym materiałem testowym. Jeżeli użycie ich jest rozważane, wymaga odrębnej podstawy, ograniczenia zakresu i zabezpieczeń adekwatnych do danych. W wielu przypadkach bezpieczniejszy jest zestaw zanonimizowany albo syntetyczny, z jasno opisanymi ograniczeniami testu.
Obserwacja po wdrożeniu i możliwość wycofania
Przed zmianą produkcyjną określ kryteria sukcesu, warunki zatrzymania oraz sposób powrotu. Kryterium nie powinno ograniczać się do komunikatu, że deployment zakończył się powodzeniem. Może obejmować podstawowy test funkcji, wynik integracji, błędy aplikacji, obciążenie lub potwierdzenie przez właściciela procesu. Zakres zależy od systemu i nie daje automatycznej gwarancji braku zakłóceń.
Rollback trzeba ocenić wcześniej: nie każdą zmianę danych, schematu bazy lub integracji można odwrócić jednym kliknięciem. W takich przypadkach potrzebne są etapowanie, kopia, migracja zgodna wstecznie albo jasna decyzja o ryzyku. Po wdrożeniu zespół powinien wiedzieć, kto obserwuje uzgodnione sygnały i gdzie zapisuje rezultat.
Monitoring techniczny pomaga zauważyć część odchyleń, ale nie zastępuje testu procesu biznesowego ani nie oznacza całodobowej obsługi. Źródła sygnałów, progi, godziny obserwacji i eskalacja muszą zostać ustalone osobno.
Checklista pierwszego porządkowania wdrożeń
Lista pomaga przygotować rozmowę i rozpoznanie. Nie potwierdza kompletności projektu, zgodności z normą ani gotowości do automatycznego wdrażania na produkcję.
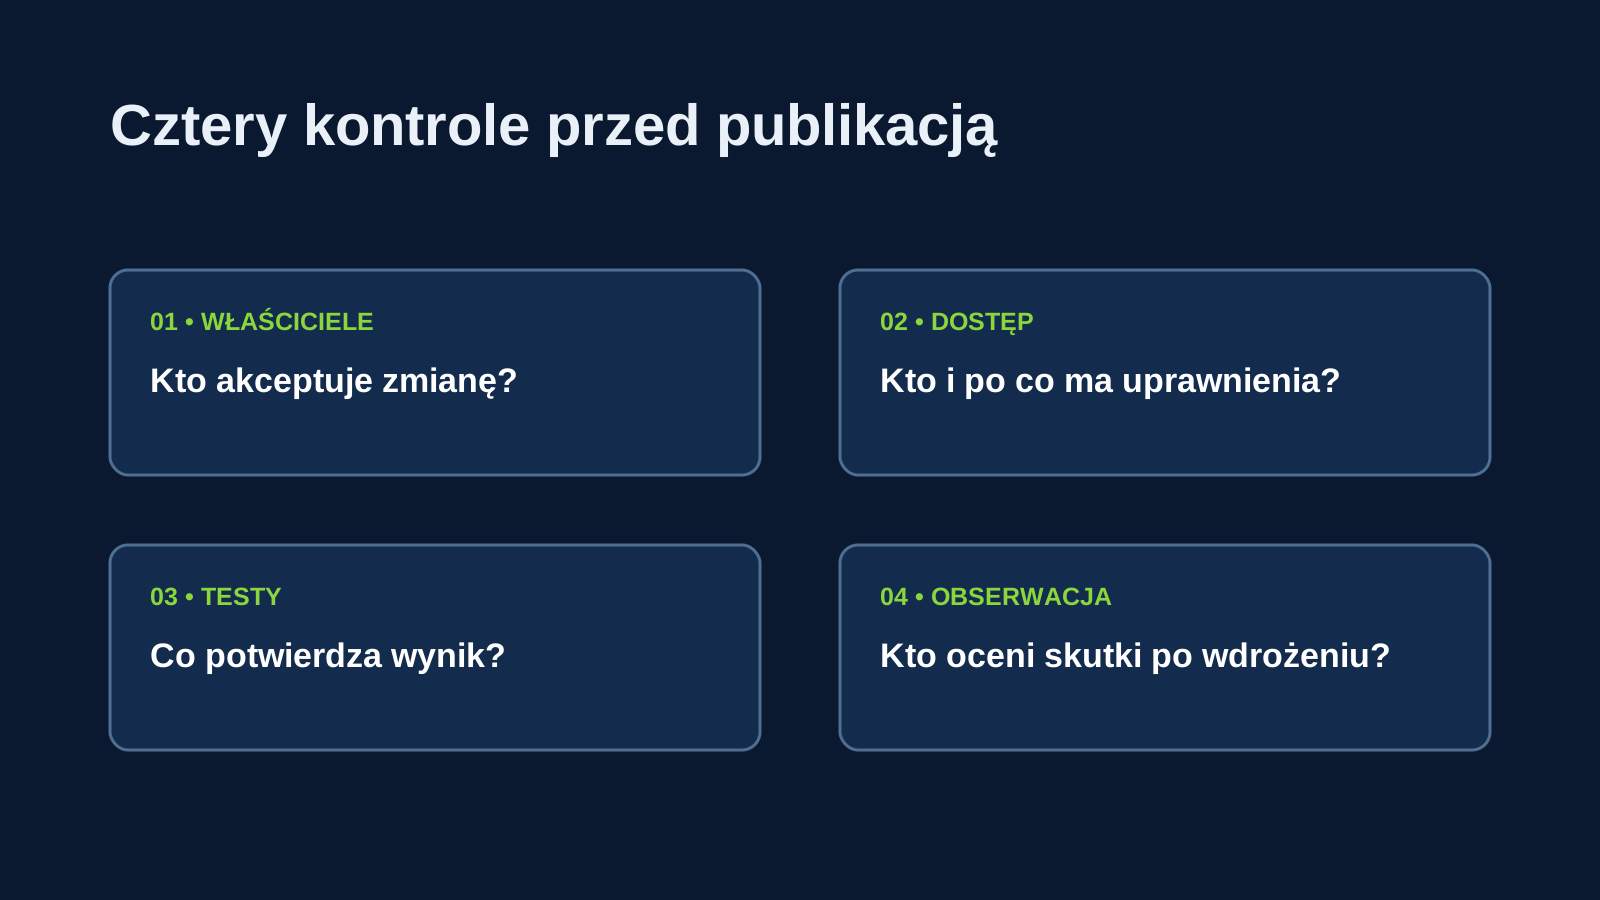
- Wskaż właścicieli aplikacji, środowisk, kont chmurowych, domen i decyzji o produkcji.
- Opisz różnice między developmentem, stagingiem i produkcją oraz krytyczne zależności.
- Ustal, które kroki pipeline’u są automatyczne, które wymagają decyzji i gdzie zostaje ślad wyniku.
- Sprawdź indywidualne tożsamości, role, MFA i proces odbierania dostępów.
- Wskaż lokalizację sekretów bez kopiowania ich wartości do dokumentacji lub formularza.
- Zapisz kryteria sukcesu, stop conditions, sposób rollbacku oraz osobę zatwierdzającą wyjątek.
- Po kontrolowanej zmianie przeglądaj wyniki, błędy i znane ograniczenia przed rozszerzeniem automatyzacji.
Kiedy potrzebna jest pomoc przy DevOps
Rozmowa ma sens, gdy wdrożenia zależą od pamięci pojedynczej osoby, nie ma jasnego właściciela kont klienta, środowiska różnią się w nieznany sposób albo zespół nie potrafi bezpiecznie wskazać drogi wycofania. Dobrym punktem startu jest ogólny opis aplikacji, liczby środowisk, dostawców, krytycznych integracji i planowanych zmian.
Usługa DevOps nie oznacza automatycznie przejęcia produkcji, wsparcia każdego stacku, pracy white-label, określonego SLA ani dostępności poza uzgodnionym zakresem. Szczegóły odpowiedzialności, godzin, uprawnień i odbioru wymagają rozpoznania projektu oraz pisemnego ustalenia.
Przekaż wyłącznie niesensytywny kontekst: typy środowisk, usługi krytyczne, zależności i termin zmiany.
Omów projekt i środowiskoŹródła
Źródła zewnętrzne zweryfikowane podczas aktualizacji 2026-10-08. Przed działaniem sprawdź ich bieżącą wersję.